云原生浪潮下的數據庫服務治理 挑戰、策略與未來
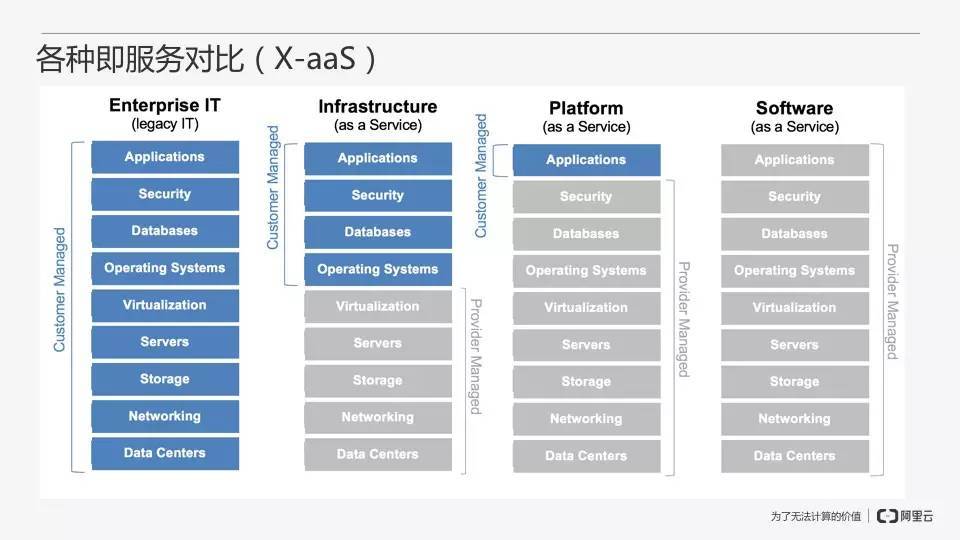
隨著云原生技術的蓬勃發展,應用架構正經歷著從單體到微服務、從靜態部署到動態編排的深刻變革。在這一背景下,作為數據核心載體的數據庫服務,其治理模式也面臨著前所未有的挑戰與機遇。傳統的集中式、靜態化管理方式已難以適應云原生環境所要求的彈性、可觀測性和自動化水平。因此,對云原生環境下的數據庫服務治理進行系統性思考,已成為保障現代應用數據層穩健、高效運行的關鍵課題。
一、核心挑戰:從靜態穩固到動態彈性
云原生環境的核心特征——容器化、微服務化、聲明式API與動態編排——為數據庫服務治理帶來了幾大根本性挑戰:
- 生命周期管理的復雜性:數據庫實例(如Pod中的數據庫容器)可能隨著應用負載的變化而頻繁創建、銷毀或遷移。如何確保在此過程中數據的一致性、服務的連續性以及配置的準確性,是傳統運維中較少遇到的難題。
- 網絡與發現的動態化:在Kubernetes等平臺中,服務IP與端點動態變化。數據庫服務如何被眾多微服務穩定、高效地發現與連接,需要融入服務網格(Service Mesh)或原生服務發現機制進行治理。
- 彈性伸縮與資源調度:數據庫的垂直與水平伸縮不再僅僅是硬件升級,而是需要與集群的自動擴縮容(HPA/VPA)策略、資源配額及存儲卷的動態供給緊密協同。
- 可觀測性深度需求:除了傳統的性能指標(QPS、延遲、連接數),在云原生場景下,更需要關注與容器平臺、調度器、網絡層相關的指標(如資源利用率、調度失敗次數、網絡延遲),實現端到端的鏈路追蹤與深度監控。
- 安全與合規的精細化:在共享、多租戶的集群中,數據庫的訪問控制、網絡策略、密鑰管理以及數據加密都需要更細粒度和自動化的策略,例如通過Operator實現安全策略的即時代碼化部署。
二、治理策略:擁抱云原生范式
應對上述挑戰,數據庫服務治理需積極擁抱云原生核心范式,向自動化、聲明式、API驅動演進。
- “數據庫即代碼”與Operator模式:采用自定義資源(CRD)和Operator(如PostgreSQL的Crunchy Operator,MySQL的Presslabs Operator)來定義和管理數據庫的期望狀態。這允許將數據庫的部署、配置、備份、高可用切換等復雜操作封裝為可重復、可版本控制的自動化流程,實現真正的GitOps。
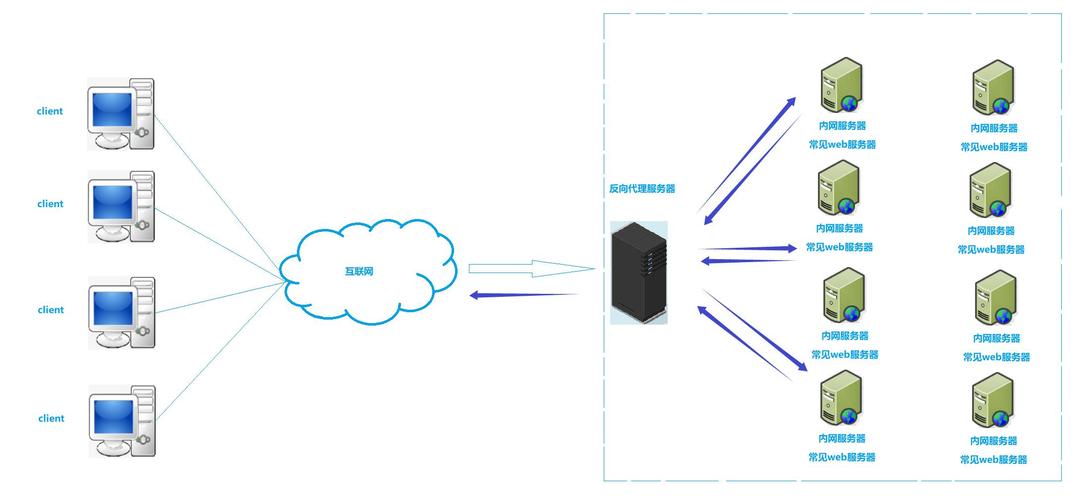
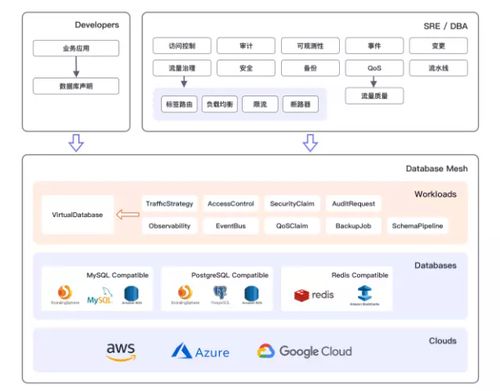
- 服務發現與連接治理:將數據庫服務無縫接入云原生服務網絡。可以通過Service Mesh(如Istio)對出站到數據庫的流量進行管理,實現負載均衡、連接池管理、故障注入和基于策略的路由。使用Secrets管理敏感連接信息,并通過sidecar或初始化容器動態配置應用連接。
- 聲明式彈性與存儲管理:利用Kubernetes的StatefulSet管理有狀態數據庫實例,結合持久卷(PV/PVC)和存儲類(Storage Class)實現存儲的動態、彈性供給。通過自定義度量指標和HPA,可以實現基于復雜業務指標(而非簡單的CPU/內存)的數據庫讀副本自動伸縮。
- 統一可觀測性棧集成:將數據庫的監控指標(通過Exporter暴露)、日志和鏈路追蹤數據,統一接入Prometheus、Loki、Jaeger等云原生可觀測性棧。利用標簽(Labels)實現多維度關聯分析,快速定位跨基礎設施、應用和數據庫的性能瓶頸。
- 安全左移與策略即代碼:在CI/CD流水線中集成數據庫schema遷移、安全策略檢查。利用OPA(開放策略代理)等工具,對數據庫的訪問模式、資源配置進行合規性校驗。網絡策略(NetworkPolicy)實現數據庫層的零信任網絡隔離。
三、未來展望:智能與融合
云原生數據庫服務治理的未來將朝著更智能、更深度融合的方向發展:
- 智能化運維(AIOps):利用機器學習分析海量遙測數據,實現異常檢測的提前預警、根因分析的自動定位,甚至自主進行性能調優與故障自愈。
- Serverless數據庫服務的深度治理:隨著Serverless數據庫的普及,治理重點將從實例管理轉向對容量規劃、冷啟動優化、成本與性能的精細權衡,以及跨云廠商服務治理的一致性。
- 數據治理與數據中臺的云原生化:數據庫服務治理將與更廣泛的數據治理(數據質量、血緣、目錄)相結合,在云原生架構下構建敏捷、可控的數據中臺,支持數據資產的快速發現、安全共享與高效利用。
###
在云原生環境下,數據庫服務治理已不再是孤立的、面向靜態資源的后臺管理,而是演進為貫穿應用開發生命周期、深度融入平臺生態的、以API為中心的持續性協同過程。其核心目標是在保障數據安全性、一致性與可靠性的前提下,最大化釋放數據庫的敏捷性與彈性潛力,從而為上層業務的快速創新提供堅實而靈活的數據基石。面對這一轉變,組織需要從技術、流程和人員技能上進行全面升級,方能駕馭云原生時代的數據洪流。
如若轉載,請注明出處:http://m.638e.cn/product/14.html
更新時間:2026-11-11 22:21:17